Wie kann man einen schwer zugänglichen, historischen und gleichzeitig hochproblematischen Text verständlicher machen und aufzeigen, welche menschenverachtenden Aussagen darin stecken?
Wer heute verstehen will, wie Hitlers Mein Kampf rhetorisch funktioniert, steht vor einem Dilemma. Im Netz finden sich vor allem unkommentierte, oft fehlerhaft gescannte Textfassungen ohne jede historische Einordnung. Auf der anderen Seite steht die wissenschaftlich wegweisende, über 2.000 Seiten umfassende historisch-kritische Edition des Instituts für Zeitgeschichte (IfZ). Sie ist das unverzichtbare Referenzwerk der Forschung; durch die Fülle an Fußnoten und Textvarianten lässt sie sich für Laien oder Schüler jedoch kaum flüssig lesen, um die demagogische Mechanik des Textes im Zusammenhang zu erfassen.
Mein Ziel war deshalb ein ergänzender Ansatz aus dem Bereich der Digital Humanities: eine digitale Leseedition, die den Text durch eine moderne Sprachfassung zugänglich macht, ihn über eine Konkordanz fest an die historische Forschung bindet und propagandistische Strukturen algorithmisch aufschlüsselt.
Der technische Ausgangspunkt für dieses Experiment war eine „Übersetzungswerkstatt“ für E-Books, die ich zuvor als Hobby-Projekt entwickelt hatte. Die Software war ursprünglich darauf ausgelegt, englische EPUBs in Absätze zu zerlegen, sie von Sprachmodellen übersetzen zu lassen und anschließend die Qualität zu bewerten.
Für Mein Kampf habe ich diesen Workflow um drei analytische Schritte erweitert: das Prüfen der sprachlichen Verdichtung im Kontext, das Verknüpfen der Absätze mit der IfZ-Edition und das Untersuchen der Quelle auf menschenverachtende Aussagen. Am Ende steht eine Leseedition, die diese Informationen direkt beim Lesen visuell zusammenführt.
Ein alter Text in neuer Sprache
Was in den ersten Kapiteln gleich auffällt, ist, dass der Text des Buchs ausschweifend, voller Wiederholungen und sprachlich oft schwer zugänglich ist. Meine erste Aufgabe war deshalb, jeden Absatz auf seinen wesentlichen Inhalt zu verdichten und in modernes, leicht verständliches Deutsch zu übertragen:
Originaltext:
„Da er endlich als Sechsundfünfzigjähriger in den Ruhestand ging, hätte er doch diese Ruhe keinen Tag als ‚Nichtstuer‘ zu ertragen vermocht. Er kaufte in der Nähe des oberösterreichischen Marktfleckens Lambach ein Gut, bewirtschaftete es und kehrte so im Kreislauf eines langen, arbeitsreichen Lebens wieder zum Ursprung seiner Väter zurück.“
(Konkordanz: B1-K01-A006 | IfZ-Edition, Bd. 1, S. 3 · d2023412e14078)
Kompaktat (§ 17):
„Mit 56 Jahren ging er in den Ruhestand. Er ertrug das Nichtstun jedoch nicht. Nahe Lambach kaufte er ein Gut und bewirtschaftete es. So kehrte er zum Ursprung seiner Väter zurück.“
(Leseedition: § 17)
Das Ergebnis nenne ich Kompaktat. Es soll klarer und kürzer sein, dabei aber die Aussagen, die Perspektive des Autors und die Zusammenhänge des Originals bewahren. Gerade bei diesem Buch ist das entscheidend: Wird eine antisemitische Behauptung in der Bearbeitung zu einer vagen Formulierung, geht ein wesentlicher Teil ihrer Bedeutung verloren oder man läuft Gefahr, dass hochproblematische Passagen komplett verschwinden, was einer Relativierung (ugs. „Weichspülen“) gleichkäme.
Wie die Übersetzung entstand
Die Werkstatt arbeitet mit Übersetzungsprojekten und Läufen. Das Ausgangs-EPUB wird in Absätze zerlegt. Für jeden Absatz entstehen eine Quellfassung und eine bearbeitete Fassung, die ich in der Werkstatt vergleichen, bearbeiten und bei Bedarf neu übersetzen lassen kann.
Zunächst habe ich mit einem lokalen Sprachmodell einzelne Absätze ausprobiert. Anschließend habe ich den größten Teil des Buchs mit Gemini 3.8 Flash in drei Batches à 700-1000 Absätzen bearbeiten lassen. Von 2.709 Anfragen (bei insgesamt 2.745 Buchabsätzen) beantwortete das Modell 179 mit einer Verweigerung statt mit einem Kompaktat. Diese Absätze habe ich anschließend mit einem lokalen LLM bearbeitet.
Damit lag für das Buch eine erste Fassung vor. Die eigentliche Arbeit begann aber beim Prüfen: Welche Aussagen hatte das Modell erhalten? Wo hatte es zu stark gekürzt? Wo ging ein Zusammenhang über die Grenze eines Absatzes hinaus?
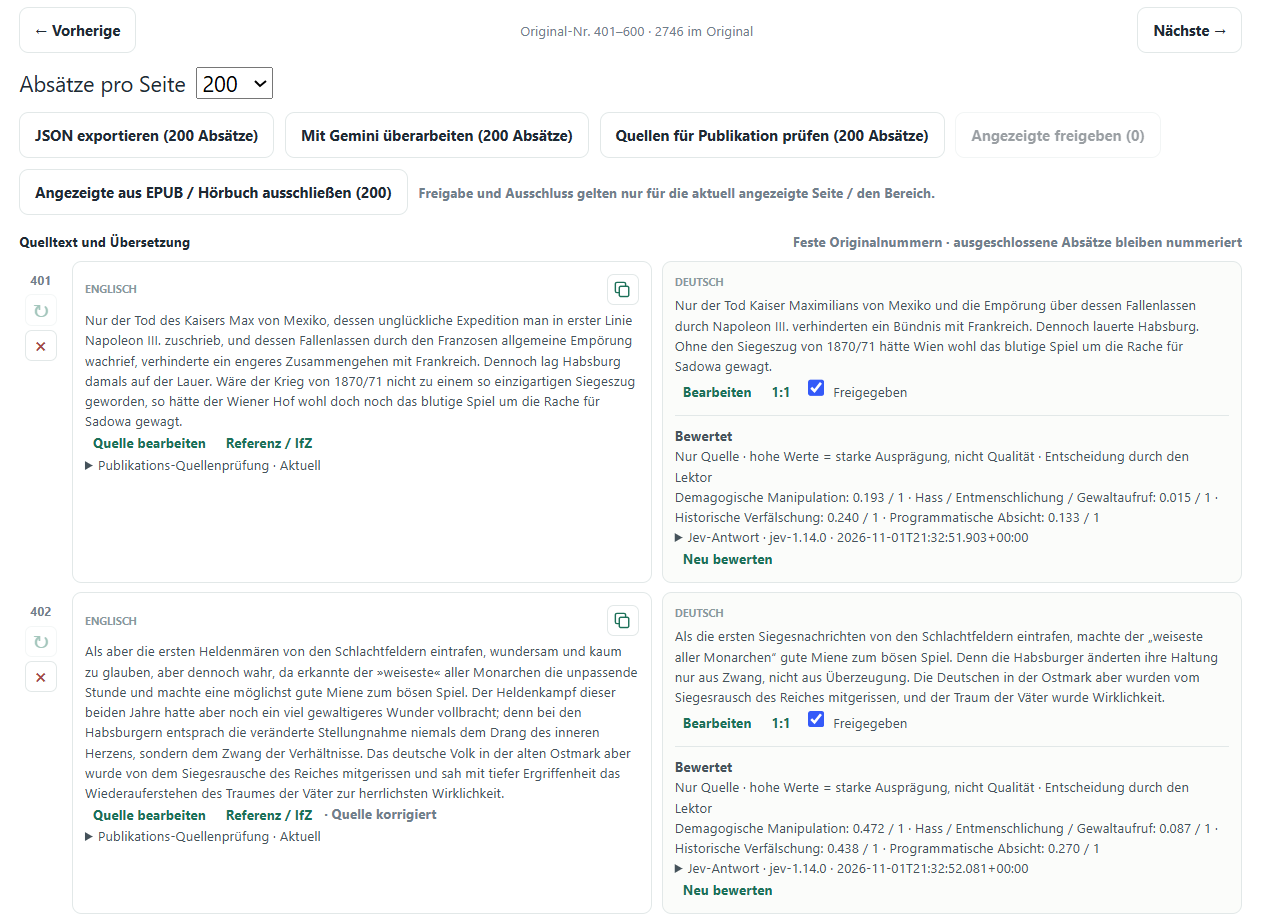
Abbildung 1: Blick in das Backend der Übersetzungswerkstatt. Original und Kompaktat werden gegenübergestellt, mit dem IfZ-Referenzwerk verknüpft und maschinell vorbewertet.
Gegenlesen mit Kontext
Ein Absatz steht selten allein. Ein Satz kann im vorherigen Absatz beginnen, eine Begründung im nächsten folgen. Deshalb habe ich für das Kontextlektorat jeweils drei Absätze an das Modell gegeben: den aktuellen Absatz und seine beiden Nachbarn, jeweils in Quelle und bearbeiteter Fassung. Überarbeitet wurde der aktuelle Absatz.
Der Prüfauftrag war konkret: Stimmen Grammatik und Zeitform? Sind Ursache und Wirkung erhalten? Passt der Absatz an seine Nachbarn? Und vor allem: Hat die Verdichtung rassistische, antisemitische oder andere radikale Aussagen abgeschwächt oder ausgelassen?
Das Modell sollte solche Stellen anhand der Quelle korrigieren und die Verdichtung dabei erhalten. Es sollte weder Inhalte hinzuerfinden noch Aussagen verschärfen. Eine erste Version des Prüfauftrags erwies sich als unbrauchbar; nach einer Überarbeitung des Prompts lief das Kontextlektorat erneut und später, nach dem Quellenabgleich, ein zweites Mal.
Zurück zur Quelle: die Konkordanz
Beim Arbeiten mit dem Ausgangs-EPUB zeigte sich ein weiteres Problem: Die Quelle hatte Fehler und Abweichungen. Ich habe sie deshalb mit der kritischen IfZ-Edition abgeglichen und Korrekturen vorgenommen. Dieser Schritt war für mein Ausgangsmaterial wichtig, da es OCR-/Scanfehler enthielt und vereinzelte Absätze abgeschnitten waren.
Aus dem Abgleich entstand eine Konkordanz: Sie ordnet die bearbeiteten Passagen den Stellen in der IfZ-Edition zu. Eine Passage kann dabei auf mehrere Quellstellen verweisen. So lässt sich eine moderne Fassung mit ihrem Ausgangstext vergleichen, eine Stelle korrekt nachschlagen und der Weg zu den editionskritischen Hinweisen des IfZ finden.
Für zukünftige Projekte ist die allgemeine Idee dahinter die dauerhafte Verbindung zur Quelle. Wie aufwendig die Vorbereitung dafür ausfällt, hängt vom jeweiligen Ausgangsmaterial ab.
Was steckt in einem Absatz?
Neben der Übersetzung wollte ich Leserinnen und Lesern ein Werkzeug geben, um die Quelle einzuordnen. Dafür habe ich jeden Absatz mit Jev, einem sehr schnellen System One Model, also einem Entscheidungsmodell, das die Erstklassifizierung durchführt, anhand von vier Merkmalen (Bewertungs-Prompt) bewerten lassen:
- Hass und Aufstachelung
- historische Verzerrung
- Programmatik
- demagogische Manipulation
In der Leseedition erscheinen diese Merkmale als vier Balken neben dem Text. Sie beziehen sich auf die ungekürzte Quelle. Ein Balken zeigt, wie stark das jeweilige Merkmal nach Einschätzung des Modells in diesem Absatz ausgeprägt ist. Die vier Werte bleiben getrennt: Eine Passage kann beispielsweise stark manipulativ sein, ohne dass derselbe Wert für alle anderen Merkmale gelten muss.
Zusätzlich gibt es Kapitelprofile, die einen Überblick über die bewerteten Absätze eines Kapitels geben. So kann man sowohl eine einzelne Stelle als auch größere Zusammenhänge betrachten.
Neben den eher informativen Balken ist das wichtigste Merkmal auf visueller Ebene die Darstellung der roten, rautenförmigen Warnhinweise, angelehnt an die GHS-Gefahrstoffkennzeichnung. Sie markieren Absätze, in denen harte ideologische Grenzen überschritten werden.
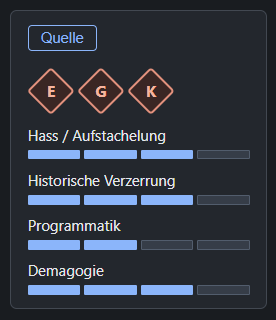
Abbildung 2: Das Analyse-Panel eines Absatzes. Die Balken messen das diskursive Grundrauschen, die roten Rauten fungieren als strikte Warnhinweise.
Warum ist eine Stelle problematisch?
Um das „Warum?“ einer problematischen Stelle zu beantworten, habe ich ein eigenes, kalibriertes Prüfverfahren entwickelt (im Folgenden „V2“ genannt, da die erste Version zu viele false positives erzeugt hatte und komplett verworfen wurde).
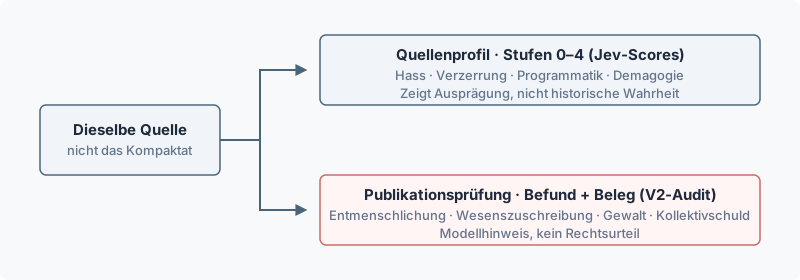
Abbildung 3: Zwei getrennte Werkzeuge. Balken und Warnhinweise evaluieren ausschließlich das Original, nie das Kompaktat.
Dass beide Prüfungen am Originaltext ansetzen und nicht am Kompaktat, hat einen einfachen Grund: Das Kompaktat ist eine gekürzte KI-Zusammenfassung. Würde man es bewerten, würde man nur die Arbeit des Modells prüfen. Ein belastbarer Warnhinweis muss sich aber am unverfälschten Wortlaut der Quelle belegen lassen.
Während erste Probeläufe zu sensibel auf allgemeines historisches Pathos reagierten, arbeitet V2 mit strikten Differenzierungen: Das Modell muss klären, ob sich eine entmenschlichende Metapher tatsächlich auf Menschen oder lediglich auf eine abstrakte Idee bezieht. Um den Kontext zu erfassen, erhält das Modell den Zielabsatz immer zusammen mit seinen direkten Nachbarabsätzen (N-1, N+1) und muss seine abschließende Einschätzung zwingend mit wörtlichen Textbelegen begründen.
Ein Warnhinweis wird nur dann ausgelöst, wenn die Prüfung mindestens eines der folgenden vier Kriterien erfüllt:
- Entmenschlichung (DEHUMANIZATION): Die Gleichsetzung von Menschen mit Krankheitserregern, Parasiten oder Ungeziefer. Hier prüft das Modell präzise, ob Personen gemeint sind und nicht bloß abstrakte Ideologien oder Institutionen (etwa „der Marxismus als Seuche“).
- Rassistische Wesenszuschreibung (RACIST_ESSENTIALISM): Die biologistische Zuschreibung angeborener, unveränderlicher Minderwertigkeit, destruktiver Eigenschaften oder naturgegebener Überlegenheit gegenüber anderen Gruppen aufgrund von Abstammung oder ethnischer Zugehörigkeit.
- Entrechtung oder Gewalt (RIGHTS_VIOLENCE): Die Forderung, Rechtfertigung, Billigung oder Androhung von Rechtlosstellung, Vertreibung, Gewalt oder Vernichtung gegenüber einzelnen Personen oder Menschengruppen.
- Dämonisierende Kollektivbeschuldigung (DEMONIZING_COLLECTIVE_BLAME): Die Unterstellung einer planmäßigen, kollektiven Wirkungsweise einer Gruppe zur systematischen Vergiftung, Unterwanderung oder Zerstörung von Staat, Gesellschaft oder Kultur.
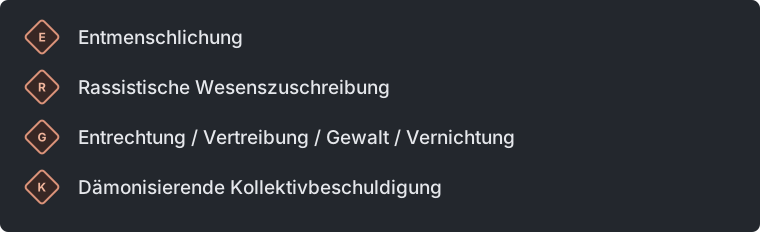
Abbildung 4: Die Legende der vier V2-Warnsymbole aus der Benutzeroberfläche.
Nach der Kalibrierung dieses Prompts habe ich 2.745 Absätze prüfen lassen. Die maschinelle Vorprüfung ordnete 2.152 Absätze als unauffällig ein (NO_FINDING), markierte 489 Absätze für einen harten Warnhinweis (SOURCE_ONLY) und flaggte 104 Absätze als mehrdeutige Grenzfälle (REVIEW_REQUIRED), bei denen das Modell die möglichen alternativen Lesarten benennen musste. Diese Zahlen spiegeln das ungefilterte Ergebnis des algorithmischen Prüfauftrags wider. Weitere ausgewählte Stellen habe ich anschließend KI-gestützt redaktionell zweitbewerten lassen.
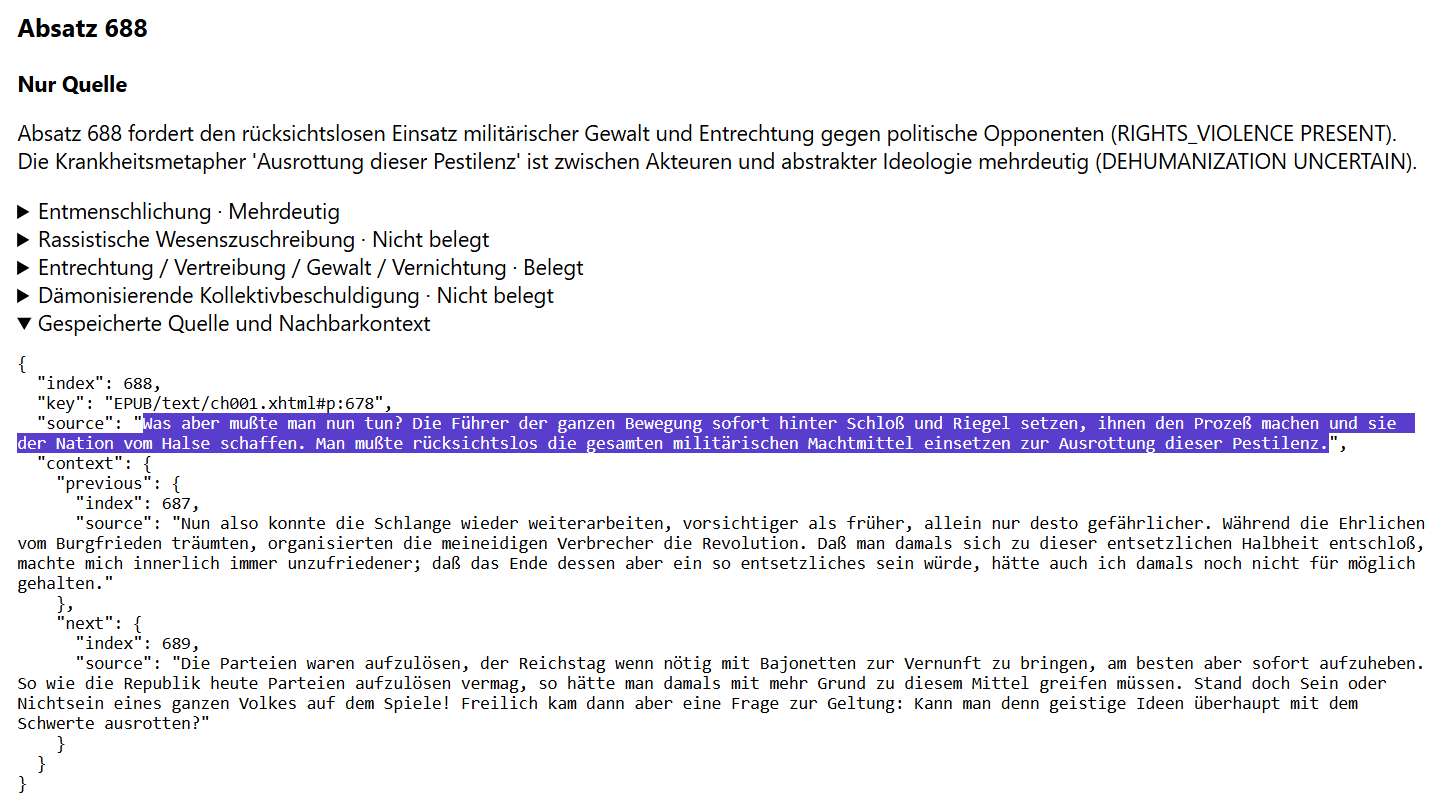
Abbildung 5: Transparenz der Modellentscheidung im Backend. Ein geöffneter Warnhinweis zeigt detailliert, warum ein Absatz als toxisch eingestuft wurde, inklusive Nachbarabsätzen (Sliding Window).
Wie präzise die Methodik bei mehrdeutigen Grenzfällen (REVIEW_REQUIRED) greift, zeigt die aufgeklappte Begründung im Detail:
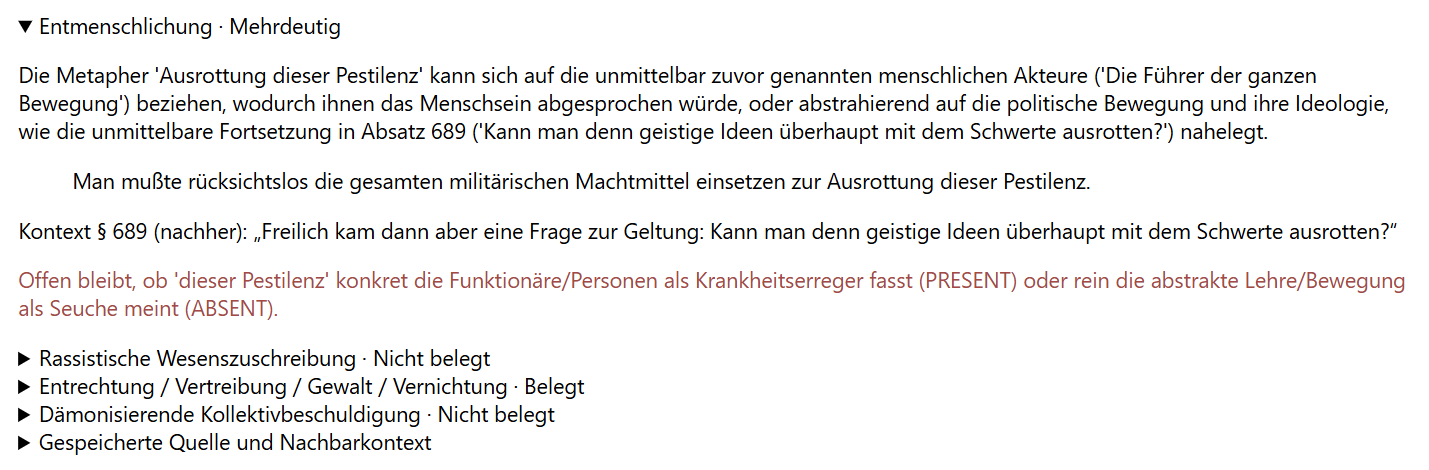
Abbildung 6: Expandierte Detailansicht im Backend. Das Modell erkennt die Mehrdeutigkeit der Metapher „Pestilenz“ und zieht zur Klärung eigenständig den Kontext heran.
Wichtig ist an dieser Stelle: Diese Analyse ist ein rhetorisch-ideologisches Diskurs-Audit mittels LLM, kein historischer Faktencheck. Wenn ein Absatz keine Warnung (NO_FINDING) erhält, bedeutet das nicht automatisch, dass die darin aufgestellten historischen Behauptungen wahr oder harmlos sind. Es bedeutet lediglich, dass die engen formalen Kriterien für Hassrede oder Entmenschlichung nicht ausgelöst wurden. Wer Hitlers historische Lügen aufdecken will, muss der Konkordanz zum IfZ-Kommentar folgen.
Die Leseedition und das „Synthesizer“-Dilemma
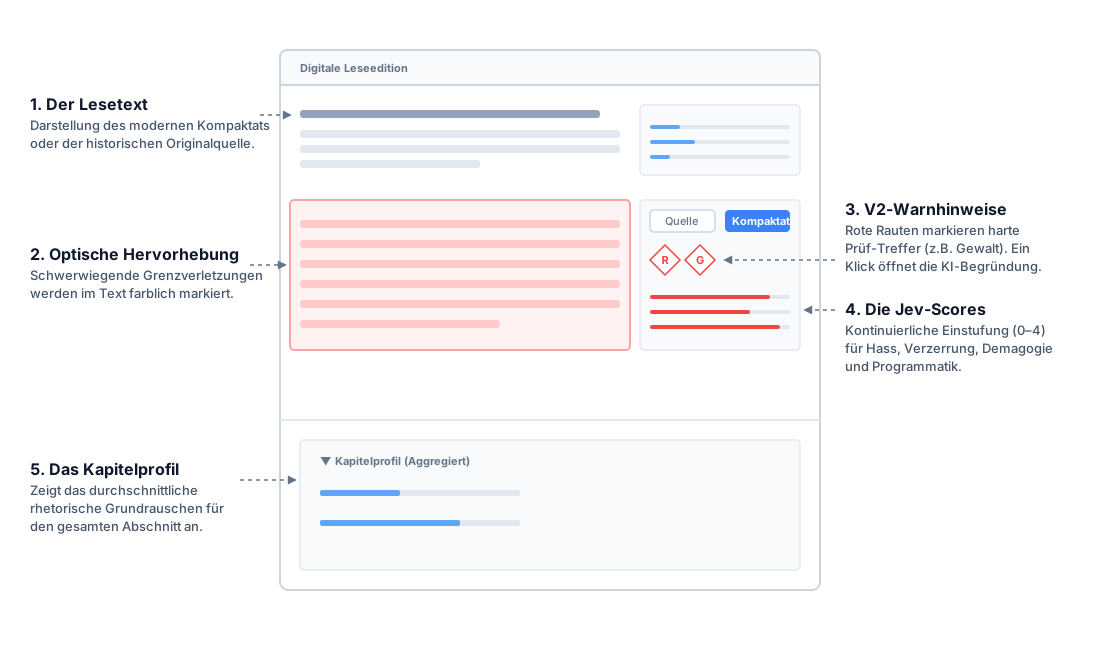
Abbildung 7: Aufbau der digitalen Leseedition. Lesetext, Warnhinweise, Merkmalsbalken und Kapitelprofil greifen in der Benutzeroberfläche direkt ineinander.
Das Ergebnis verbindet beide Bände, 27 Kapitel und das Schlusswort in einer digitalen Leseedition. Der Lesetext besteht aus den Kompaktaten. Daneben stehen die vier Merkmalsbalken; über Hinweise lassen sich problematische Aussagen und ihre Begründungen aufrufen. Ein Wechsel zur Quelle zeigt den Ausgangstext und die Konkordanz.
Bei besonders toxischen Passagen stand ich vor einem Design-Dilemma: Zeigt man dort ausschließlich das ungekürzte Original, geht dessen Radikalität für heutige Leser leicht in Hitlers zäher Grammatik unter. Macht man hingegen das Kompaktat zum direkten Einstieg, fungiert das Sprachmodell unweigerlich als „Synthesizer“, der redundante Hetze in prägnantes Gegenwartsdeutsch übersetzt.
Die Lösung im Interface ist eine gestufte Kopplung: Während im regulären Lesetext das Kompaktat direkt erscheint, zeigt die Leseedition bei hochproblematischen Absätzen zunächst den rot hinterlegten Originaltext. Das Kompaktat lässt sich per Button zuschalten, bleibt dabei aber untrennbar an die roten Warnhinweise und die methodische Begründung gebunden. Man kann die verdichtete Aussage nicht betrachten, ohne gleichzeitig ihre demagogische Mechanik vor Augen zu haben.
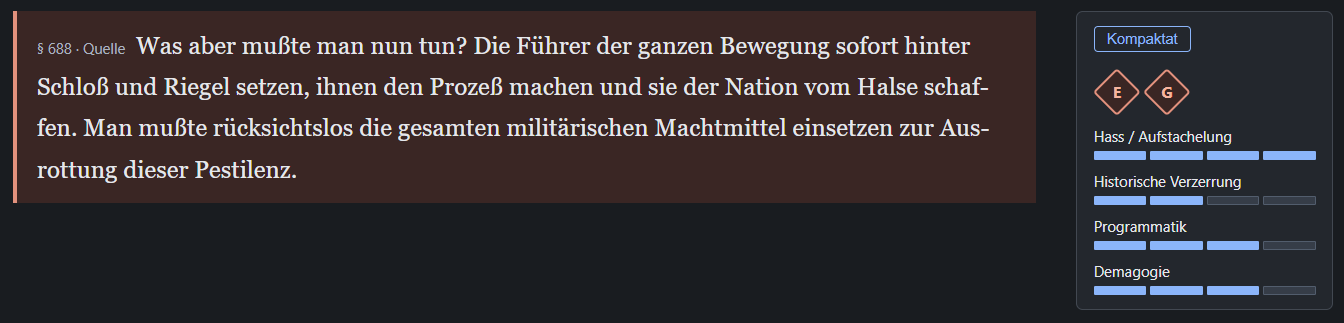
Abbildung 8: Die finale Leseedition. Für hochproblematische Absätze lassen sich Kompaktat und Warn-Apparat nur untrennbar gekoppelt zuschalten.
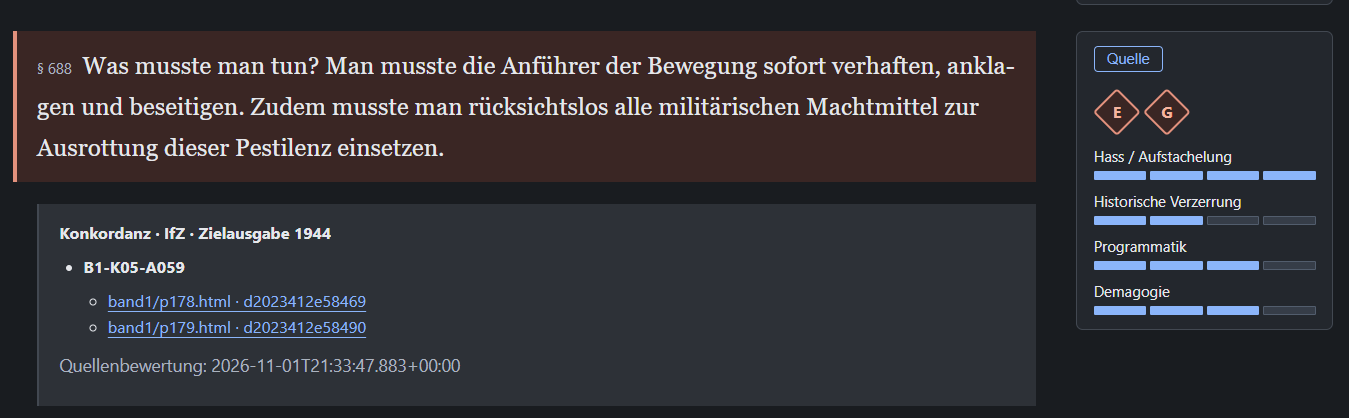
Abbildung 9: Die Konkordanz. Sie verknüpft den Lesetext direkt mit den exakten Seiten und Zeilen der kritischen IfZ-Referenzausgabe.
Die Warnsymbole sind dabei keine undurchsichtigen Blackbox-Urteile. Klickt man auf eine der roten Rauten, öffnet sich direkt unter dem Absatz die detaillierte Begründung des V2-Audits. Der Nutzer sieht sofort, warum das Modell angeschlagen hat, und welcher konkrete Satz den Ausschlag gab.
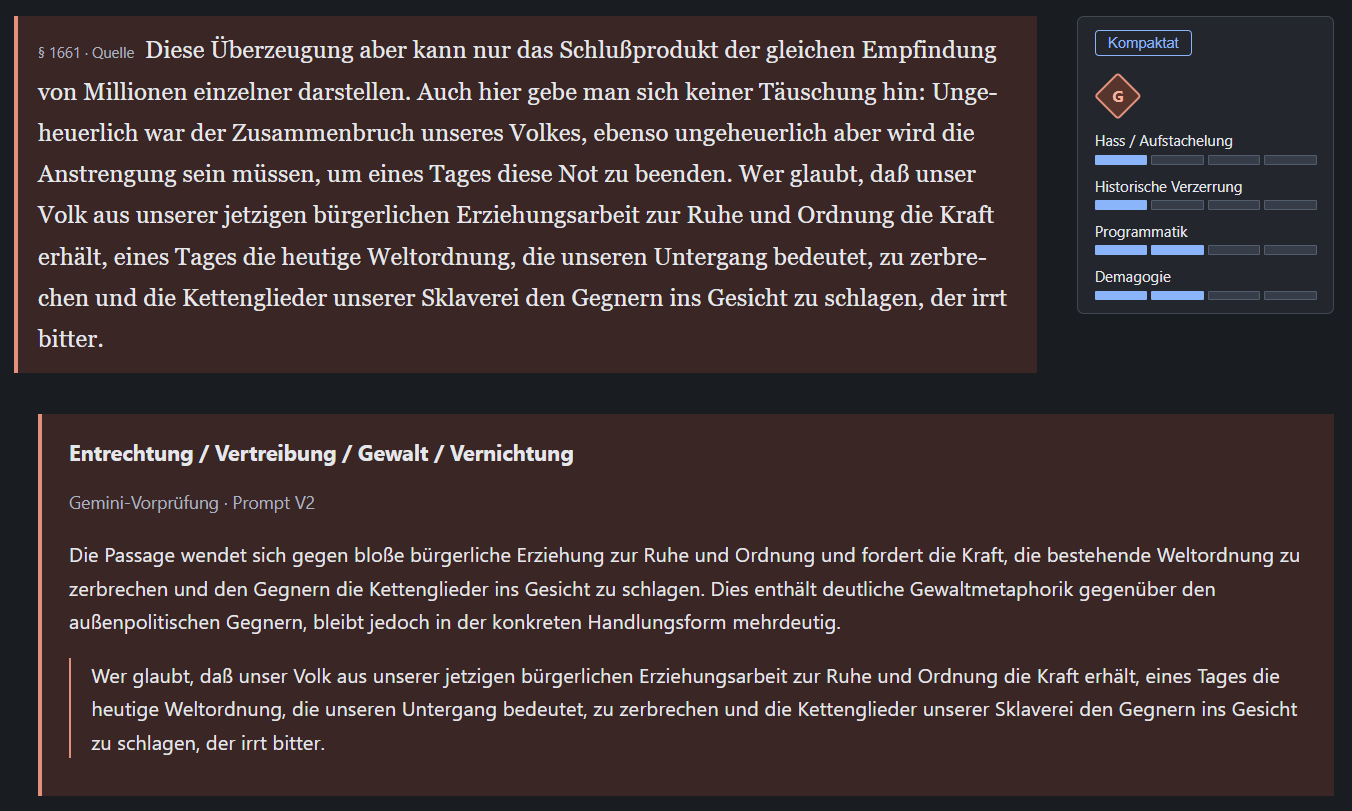
Abbildung 10: Transparenz im Web-Reader. Beispiel einer geöffneten V2-Begründung für die Kategorie „Gewalt“ (G) inklusive dem ausschlaggebenden Textzitat.
Der Wechsel zur Originalquelle steht zur Überprüfung zudem stets offen. Um die wissenschaftliche Anbindung zu wahren, ist der Text dauerhaft mit der historischen Forschung verknüpft.
Eine Werkstatt für weitere Texte?
Das Experiment entstand für ein konkretes Buch. Die einzelnen Schritte lassen sich aber auch als Ausgangspunkt für andere Projekte betrachten:
- Einen Text absatzweise in eine verständliche Fassung übertragen.
- Die Fassung anhand der Quelle und ihres Kontexts auf Bedeutungsverlust prüfen.
- Jede bearbeitete Passage über eine Konkordanz mit ihren Quellen verbinden.
- Die Quelle anhand nachvollziehbarer Kriterien untersuchen und Befunde begründen.
- Text, Quelle und Einordnung in einer gut lesbaren Ausgabe zusammenbringen.
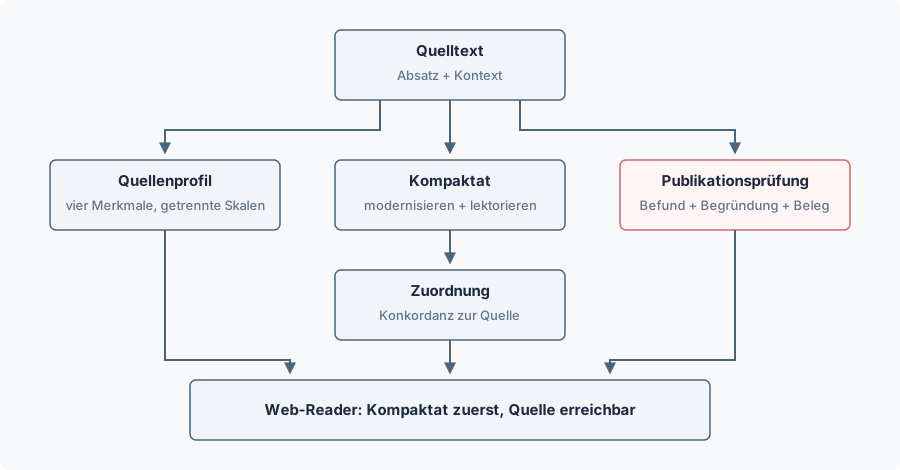
Abbildung 11: Architektur der Werkstatt. Quellenprofil, Kompaktat und Publikationsprüfung werden parallel aus dem Originaltext generiert und fließen erst im Web-Reader zusammen.
Der Aufbau der Übersetzungswerkstatt, ihre Prompts und die Leseedition sollen dafür als praktischer Ausgangspunkt dienen. Für eine Veröffentlichung des Quellcodes bereite ich eine bereinigte Fassung vor, getrennt von den projektspezifischen Daten.
Aufwand, Modelle und API-Kosten
Neben den methodischen Fragen ist auch der reale Aufwand für ein solches Digital-Humanities-Projekt relevant:
Zeitlicher Aufwand
Meine Schätzung für das dokumentierte Experiment liegt bei 30 bis 40 Stunden eigener Arbeit. Das Experiment wurde dabei Ende Oktober/Anfang November 2026 durchgeführt. Allein der manuelle Quellenabgleich erstreckte sich über rund neun Stunden; dazu kamen die Übersetzung, Korrekturen, das Prompt-Engineering und der Bau der digitalen Leseedition.
(Hinweis: Frühere Entwicklungsarbeiten an der “Übersetzungswerkstatt” sowie das spätere Schreiben dieses Artikels sind nicht vollständig erfasst. Der Gesamtaufwand kann also höher liegen.)
Eingesetzte Sprachmodelle
Das Projekt nutzte eine Kombination aus kommerziellen und lokalen Modellen:
- Gemini (gemini-3.8-flash): Kompaktierung, Kontextlektorat und Publikationsprüfung. Insgesamt 10.161 Einzelanfragen.
- Gemma (gemma4:26b): Lokale Kompaktierung und Ersatz verweigerter Antworten. Insgesamt 194 protokollierte Einzel-Reruns, darunter die Bearbeitung von 179 durch Gemini verweigerten Absätzen.
- Jev (jev-1.14.0): Bewertung der historischen Quelle für die kontinuierlichen Merkmalsbalken (Jev-Scores). Bearbeitung von 2.744 Absätzen im Gesamtlauf (zuzüglich drei Einzelproben).
Aufwand, Token-Verbrauch und API-Kosten
Die reinen API-Kosten für die eingesetzten LLMs lagen bei rund 41 Euro. Davon entfielen 35,89 € auf Gemini, berechnet anhand der gespeicherten Usage, der Batch-Tarife und eines festen USD/EUR-Wechselkurses. Umgerechnet entspricht das bei 2.745 Absätzen etwa 1,31 Cent Gemini-Kosten pro Absatz. Hinzu kamen rund 5 € für Jev; Kosten für lokale Hardware und Strom sind nicht enthalten.
| Arbeitsschritt | Anfragen | Input Tokens | Output Tokens | Kosten |
|---|---|---|---|---|
| Kompaktierung | 2.709 | 1.366.518 | 2.793.347 | 5,14 € |
| Kontextlektorat (Runde 1) | 2.910 | 4.338.438 | 5.167.332 | 10,11 € |
| Kontextlektorat (Runde 2) | 1.607 | 2.500.574 | 2.330.280 | 4,74 € |
| Publikationsprüfung (V2) | 2.935 | 9.794.677 | 7.567.810 | 15,90 € |
| Gesamt | 10.161 | 18.000.207 | 17.858.769 | 35,89 € |
Fazit
Das Experiment zeigt, wie viel methodische und redaktionelle Arbeit zwischen einer ersten KI-Verdichtung und einer belastbaren digitalen Ausgabe liegt. Der eigentliche Mehrwert entsteht im Zusammenspiel von sprachlicher Zugänglichkeit und technischer Kontrolle: Der historische Text wird lesbar, bleibt über die Konkordanz an die Originalquelle rückgebunden und wird durch am Text belegte Prüfhinweise in seiner propagandistischen Mechanik offengelegt.
Sprachmodelle liefern dabei keine endgültigen Urteile, sondern strukturierte Vorschläge und Vorbewertungen. Ob eine Verdichtung den historischen Sinn wahrt und eine Klassifizierung trägt, entscheidet sich erst in der fachlichen Kontrolle am Originaltext, einschließlich einer sauberen Überprüfung von Quellengrundlage, Zitaten und Zugänglichkeit.
Zur Einordnung: Diese Leseedition versteht sich als diskursanalytisches Werkzeug, nicht als Ersatz einer kommentierten Ausgabe. Die Konkordanz verweist gezielt auf die historisch-kritische Edition des Instituts für Zeitgeschichte (IfZ), da erst deren Kommentierung den notwendigen historischen Faktencheck leistet. Es handelt sich um ein unabhängiges Projekt ohne Beteiligung oder Autorisierung des IfZ. Die Leseedition ist strikt als Ergänzung konzipiert und darf nicht isoliert von der IfZ-Referenzausgabe verwendet oder als eigenständige historische Quelle zitiert werden.
Als Blueprint lässt sich dieser Ansatz auf andere schwierige oder historisch belastete Texte übertragen: überall dort, wo Inhalte verständlich erschlossen werden sollen, ohne ihre problematischen Strukturen zu glätten oder sie aus dem wissenschaftlichen Kontext zu lösen.
Lizenzen und Nutzungsbedingungen
Für die Bestandteile des Projekts gelten individuelle Nutzungsbedingungen. Sie ermöglichen die nichtkommerzielle Nachnutzung, erfordern die Nennung meiner Urheberschaft und erhalten zugleich die Verbindung zur historischen Einordnung:
- Quellcode, Pipeline, System-Prompts, Audit-Datensatz, Methodik und Blogartikel dürfen für nichtkommerzielle Zwecke genutzt, verändert und weitergegeben werden.
- Kompaktate und digitale Leseedition dürfen nichtkommerziell nur zusammen mit den zugehörigen V2-Warnhinweisen, Merkmalsbalken und der Quellenkonkordanz weitergegeben werden. Bearbeitete Fassungen hiervon dürfen nicht weiterverbreitet werden.
- Historischer Ausgangstext (Mein Kampf): Am historischen Originaltext beanspruche ich keine eigenen Rechte. In Deutschland ist dessen urheberrechtliche Schutzfrist abgelaufen. Rechte an Kommentaren und anderen Bestandteilen der IfZ-Edition bleiben davon unberührt.
Bei der Nutzung und Zitation der Projektbestandteile muss auf die historisch-kritische Edition des IfZ hingewiesen werden.
Diese Bedingungen gelten, soweit eigene Rechte an den jeweiligen Bestandteilen bestehen und gesetzliche Ausnahmen nicht entgegenstehen. Die konkreten Lizenzbedingungen und ihre rechtliche Wirksamkeit werden vor der abschließenden Veröffentlichung des Codes geprüft.